ローカルLLMの必要スペックは、まずメモリ容量で決まります。目安はパラメータ数×1パラメータあたりのバイト数(FP16で2、INT8で1、INT4で0.5)にKVキャッシュを足した値です。そのうえで応答速度はメモリ帯域、同時利用数はTOPSと消費電力の余裕で判断します。
本ガイドは、2012年創業で産業用ディスプレイ、組込みボード、HMIパネル、産業用ゲートウェイ、エッジAIコンピュータを設計・製造するBeijing Huamei Xuntong Technology Co., Ltd. (TouchVision)のエンジニアリングチームが執筆しました。
要点まとめ
- ローカルLLMの必要メモリは、パラメータ数×バイト数(FP16で2、INT8で1、INT4で0.5)にKVキャッシュを加えて見積もります。
- 7.61BパラメータのQwen2.5-7Bは、重みだけでFP16約15.2 GB、INT8約7.6 GB、INT4約3.8 GBです。
- 長い文脈と同時接続はKVキャッシュを増やすため、重みだけが収まるメモリでは不足します。
- TOPSはINT8条件の値が多く、文章生成の速度はメモリ帯域に強く依存します。
- オンプレミスでも個人情報保護法の義務は残るため、利用目的、アクセス権限、ログ管理を規程化します。
ローカルLLMのスペックは何から決めればよいですか?
ローカルLLMのハードウェア選定は、「どのモデルを、どの精度(量子化)で、何人が同時に、どれくらいの文脈長で使うか」を先に決めることから始まります。 この4つが決まると、必要なメモリ容量と演算性能がほぼ計算で求まります。
生成AIを社内で使う場合、社内LLMの典型的な用途は、社内規程やマニュアルを検索して答えるRAG(検索拡張生成)、議事録の要約、問い合わせメールの下書き、音声の文字起こしと要約などです。こうした用途では最大級のモデルは必ずしも必要なく、70億〜320億パラメータ程度のモデルを量子化して動かす構成が現実的な選択肢になります。オンプレミスLLMを選ぶ理由は、データを社外に出さないこと、従量課金に左右されないこと、閉域網でも使えることにあります。
パラメータ数からメモリ容量をどう計算しますか?
モデルの重みに必要なメモリは「パラメータ数 × 1パラメータあたりのバイト数」で概算でき、FP16なら2バイト、INT8なら1バイト、INT4なら0.5バイトです。 実際にはこれに加えてKVキャッシュと実行時の作業領域が必要になります。
例として、Hugging Faceで公開されているQwen2.5-7Bはパラメータ数が76.1億(7.61B)です。重みだけで計算すると次のようになります。
| 精度 | 1パラメータあたり | Qwen2.5-7Bの重み(概算) | 特徴 |
|---|---|---|---|
| FP16 / BF16 | 2バイト | 約15.2 GB | 精度劣化がほぼない基準値 |
| INT8 | 1バイト | 約7.6 GB | 多くの業務用途で品質と容量のバランスが良い |
| INT4 | 0.5バイト | 約3.8 GB | 省メモリだが、用途によっては品質確認が必要 |
同じ計算で、320億パラメータ級のモデルはFP16で約64 GB、INT4でも約16 GBの重みになります。パラメータ数が4倍になれば、必要なメモリもおよそ4倍になると覚えておくと便利です。
KVキャッシュはどれくらいメモリを使いますか?
KVキャッシュは、生成中の文脈を保持するためのメモリで、「2 × 層数 × KVヘッド数 × ヘッド次元 × バイト数 × トークン数」で見積もれます。 長い文書をRAGで読み込ませたり、同時利用者が増えたりすると、重みとは別にこの領域が大きくなります。
Qwen2.5-7Bの公開設定値(28層、KVヘッド4、ヘッド次元128)でFP16の場合、1トークンあたり約56 KBです。最大文脈長の32,768トークンを1セッションで使い切ると約1.9 GBになり、同時に4セッションなら約7.5 GBが追加で必要になります。つまり、モデルの重みが収まるだけのメモリでは足りず、文脈長と同時接続数ぶんの余裕が必要です。
TOPSと消費電力はどう読めばよいですか?
TOPS(1秒あたりの兆回演算)は、主に入力文の読み込みや画像・音声処理の速さと同時処理能力の目安であり、文章を1トークンずつ生成する速度はメモリ帯域に強く依存します。 そのため、TOPSの数字だけで機種を比較するのは危険です。
- 精度の条件を確認する:カタログのTOPSは多くの場合INT8の値です。FP16やBF16では実効値が下がります。
- メモリ帯域とメモリ容量を併せて見る:推論の体感速度は、TOPSよりもメモリ帯域に左右される場面が多くあります。
- 消費電力を運用コストで考える:24時間稼働する社内サーバーでは、1 TOPSあたりの消費電力と冷却の要否が電気代と設置場所を決めます。
- 実機で測る:自社の文書と質問で、初回応答までの時間と1秒あたりの生成トークン数を測定するのが最も確実です。
個人情報保護法やAI事業者ガイドラインとローカルLLMはどう関係しますか?
ローカルLLMは入力データを社外のサービスに送らずに処理できるため、個人情報の取り扱いを自社の管理下に置きやすいという利点があります。 ただし、オンプレミスで動かしても個人情報保護法上の義務がなくなるわけではありません。
個人情報保護委員会は生成AIサービスの利用に関する注意喚起で、個人情報取扱事業者が個人情報を含むプロンプトを入力する場合は利用目的の範囲内かを十分に確認すること、入力した個人データが応答の生成以外の目的で扱われる場合には法令違反となるおそれがあることを示しています。また、経済産業省と総務省の「AI事業者ガイドライン(第1.2版)」は、AIを利用する事業者に対してもリスクの把握、データの適正な管理、透明性の確保などを求めています。社内LLMを導入する際は、アクセス権限、ログの保存期間、学習に使うデータの範囲を社内規程として決めておくことが重要です。
TouchVisionのローカルLLM向け製品はどれを選べばよいですか?
TouchVisionは、部門単位のローカルLLMに向く小型アプライアンス、全社規模の推論向けラックサーバー、機器組み込み用のAIモジュールを提供しています。 下表の数値は当社製品ページに基づきます。
| 製品 | 演算性能 | 主な特徴 | 向いている用途 |
|---|---|---|---|
| YZ-B033 | INT8 32 TOPS(BM1684X) | FP32/FP16/BF16/INT8対応、DeepSeekとQwenを事前適合、ナレッジベースQ&A、音声認識・音声合成、標準消費電力17 W、-20〜+70 °C | 部門や拠点単位の社内LLM、RAG |
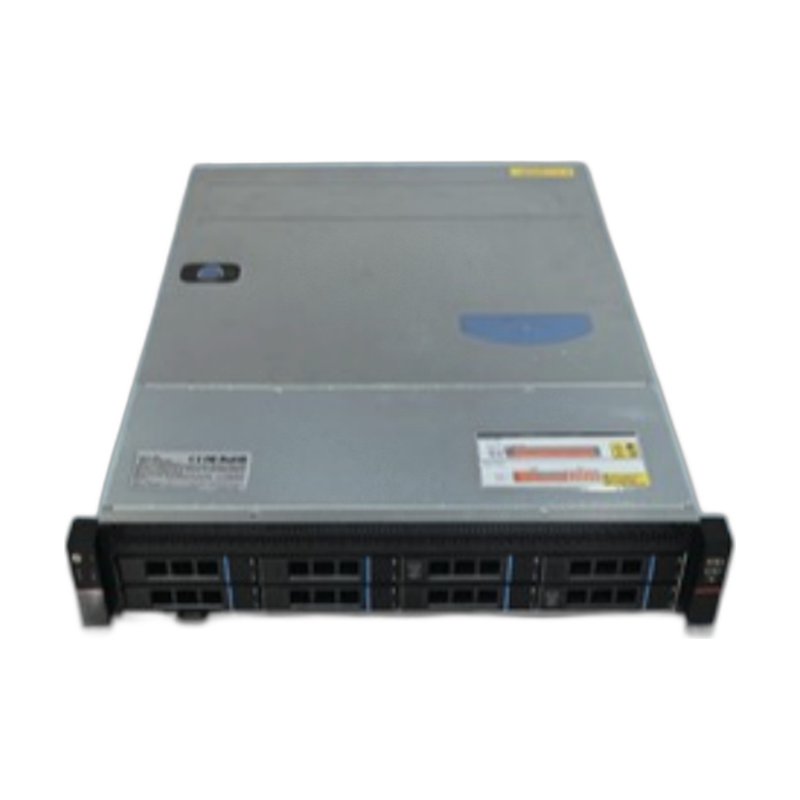
| 2U ラック型AIサーバー | 最大INT8 576 TOPS | DeepSeek、QwQ-32B、Qwen2.5に対応、1 TOPSあたり1 W未満 | 全社規模の推論、複数モデルの同時運用 |
| BM1684X AIモジュール | BM1684X搭載 | 62×58×33 mm、144ピン、ファンレス | 自社装置へのAI機能の組み込み |
YZ-B033のメモリ構成は用途に応じてお問い合わせください。前述の計算式でモデルと文脈長から必要量を見積もり、構成を相談いただくのが確実です。社内のAIエージェント基盤として使う場合はAI Super Agentも選択肢になりますが、日本向けの仕様、対応言語、認証状況は導入前に確認してください。製品群の全体像はオンプレミスAIサーバー一覧で確認できます。装置にAIを組み込む場合のボード選定は産業用ARMボードの選び方も参考になります。
ローカルLLM導入前のスペック確認チェックリスト
次の項目を埋めてから見積もりを依頼すると、過不足のない構成を選びやすくなります。
- 使いたいモデルとパラメータ数(例:7B、14B、32B)
- 許容できる量子化の精度(FP16、INT8、INT4)と品質評価の方法
- 想定する最大文脈長と同時利用者数(KVキャッシュの見積もり)
- 用途:RAG、要約、文字起こし、画像解析などの組み合わせ
- 目標の応答速度(初回応答時間、1秒あたりの生成トークン数)
- 設置場所の電源容量、騒音、冷却、ラックの有無
- 個人情報保護法と社内規程に沿ったアクセス権限とログ管理
- 保守期間、モデル更新の手順、閉域網での運用可否
TouchVisionについて TouchVisionは2012年から、産業用タッチディスプレイ、組込みボード、パネルPC、IoTゲートウェイ、エッジAIコンピュータを、標準品からOEM/ODM案件まで設計・製造しています。標準品には納品日から3年間の保証が付きます。カスタム開発についてはTouchVision OEM/ODMサイトのカスタマイズ可能な製品、または会社概要をご覧ください。
よくあるご質問
ローカルLLMにはどれくらいのメモリが必要ですか?
重みはパラメータ数×1パラメータあたりのバイト数で概算できます。7Bモデルなら、FP16で約15 GB、INT8で約7.6 GB、INT4で約3.8 GBです。これにKVキャッシュと作業領域の余裕を加えてください。
量子化するとローカルLLMの精度は落ちますか?
INT8では多くの業務用途で差が小さい一方、INT4では用途によって品質差が出ることがあります。自社の文書と質問で、量子化前後の回答を比較評価してから採用するのが安全です。
TOPSが大きいほどローカルLLMは速くなりますか?
一概には言えません。TOPSは入力の処理や同時処理の目安ですが、1トークンずつ生成する速度はメモリ帯域に強く依存します。実際の応答速度は実機で測定してください。
社内LLMをオンプレミスで動かせば個人情報保護法の対応は不要ですか?
不要にはなりません。データを社外に送らない利点はありますが、利用目的の範囲内での取り扱い、安全管理措置、アクセス権限の管理は引き続き必要です。
YZ-B033ではどのモデルを動かせますか?
YZ-B033はDeepSeekとQwenのモデルに事前適合しており、FP32、FP16、BF16、INT8に対応します。動かしたいモデルのサイズと文脈長に応じて、メモリ構成をご相談ください。