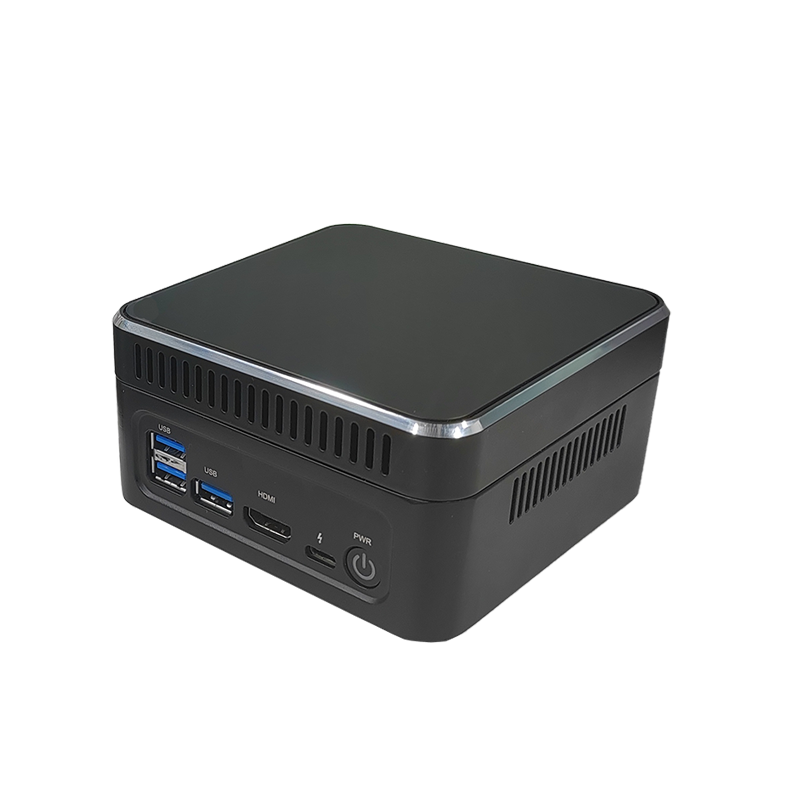
DeepSeek 및 Qwen 모델과 사내 지식 베이스를 완전히 온프레미스에서 실행하고, 영상 32채널도 분석할 수 있는 17W 엣지 어플라이언스(BM1684X, 32 TOPS INT8)입니다.
개요
YZ-B033은 GPU 서버나 클라우드 구독 없이 대규모 언어 모델을 엣지에서 구현합니다. BM1684X 가속기는 FP32/FP16/BF16/INT8 혼합 정밀도로 32 TOPS INT8 성능을 제공하며, DeepSeek 및 Qwen 모델 제품군에 사전 최적화되어 있습니다. PDF, TXT, DOCX, PPTX, 이미지 파일 기반의 지식 베이스 Q&A, 텍스트-이미지 생성, 텍스트 기반 이미지·영상 검색, 음성-텍스트 변환, 텍스트-음성 변환, 코드 생성을 별도 설정 없이 지원하며, 모든 처리는 로컬에서 이루어집니다. 또한 HD 영상 32채널 분석도 실행할 수 있어 한 대의 장치로 AI 어시스턴트와 비전 워크로드를 모두 처리할 수 있습니다.
주요 특징
- SOPHGO BM1684X, 32 TOPS INT8, FP32/FP16/BF16/INT8 혼합 정밀도
- DeepSeek 및 Qwen 오픈소스 LLM에 사전 최적화
- 사내 지식 베이스 Q&A(PDF, TXT, DOCX, PPTX, 이미지)
- 텍스트-이미지 생성, 텍스트 기반 이미지/영상 검색, ASR, TTS, 코드 생성
- HD 32채널 영상 분석, 32× 1080p@25 디코딩, 12× 1080p@25 인코딩
- 일반 소비 전력 17W, -20~+70 °C
- 듀얼 LAN, TF, 디버그 포트
사양
| 항목 | 사양 |
|---|---|
| AI SoC | SOPHGO BM1684X |
| AI 성능 | 32 TOPS INT8, FP32/FP16/BF16/INT8 |
| 모델 | DeepSeek, Qwen(기타 모델은 요청 시) |
| 비디오 | 32× 1080p@25 디코딩, 12× 1080p@25 인코딩, 32채널 분석 |
| 메모리 / 스토리지 | 문의 시 제공 |
| 인터페이스 | 2× LAN, TF, 디버그(전체 목록은 요청 시 제공) |
| 소비 전력 | 일반 17W |
| 작동 온도 | -20~+70 °C |
사양은 제조사 데이터를 기준으로 하며 변경될 수 있습니다. ‘문의 시 제공’으로 표시된 항목은 프로젝트별로 구성되므로 최신 데이터시트를 요청해 주십시오.
적용 분야
- 기업 전용 지식 어시스턴트
- 공장 및 현장 서비스 문서 Q&A
- 데이터 주권 요구사항이 있는 엣지 사무소
- AI 비전과 LLM을 함께 운영하는 현장
관련 산업 솔루션: AI 영상 분석 및 스마트 안전 · 산업 자동화 및 장비 제조사
맞춤 제작 및 주문
YZ-B033은 OEM 프로젝트에 맞게 인터페이스, 외장 또는 마운팅, 펌웨어/OS 이미지, 브랜딩을 맞춤 제작할 수 있습니다. 소량 파일럿 주문도 가능합니다. 견적 또는 샘플을 요청하시거나 WhatsApp으로 상담(+86 135 0532 6001)하시고, OEM/ODM 서비스에 대해서도 확인해 보십시오.
이 카테고리의 다른 제품: 온프레미스 LLM 및 AI 에이전트 어플라이언스
자주 묻는 질문
YZ-B033에서는 어떤 LLM을 실행할 수 있습니까?
DeepSeek 및 Qwen 모델 제품군에 사전 최적화되어 있으며, 기타 오픈소스 모델은 요청 시 검토해 드립니다.
데이터가 장치 외부로 전송됩니까?
아니요. 추론, 지식 베이스 인덱싱, 음성 처리가 모두 로컬에서 실행되므로 문서와 프롬프트는 온프레미스에 유지됩니다.
소비 전력은 얼마입니까?
일반 소비 전력은 17W입니다.